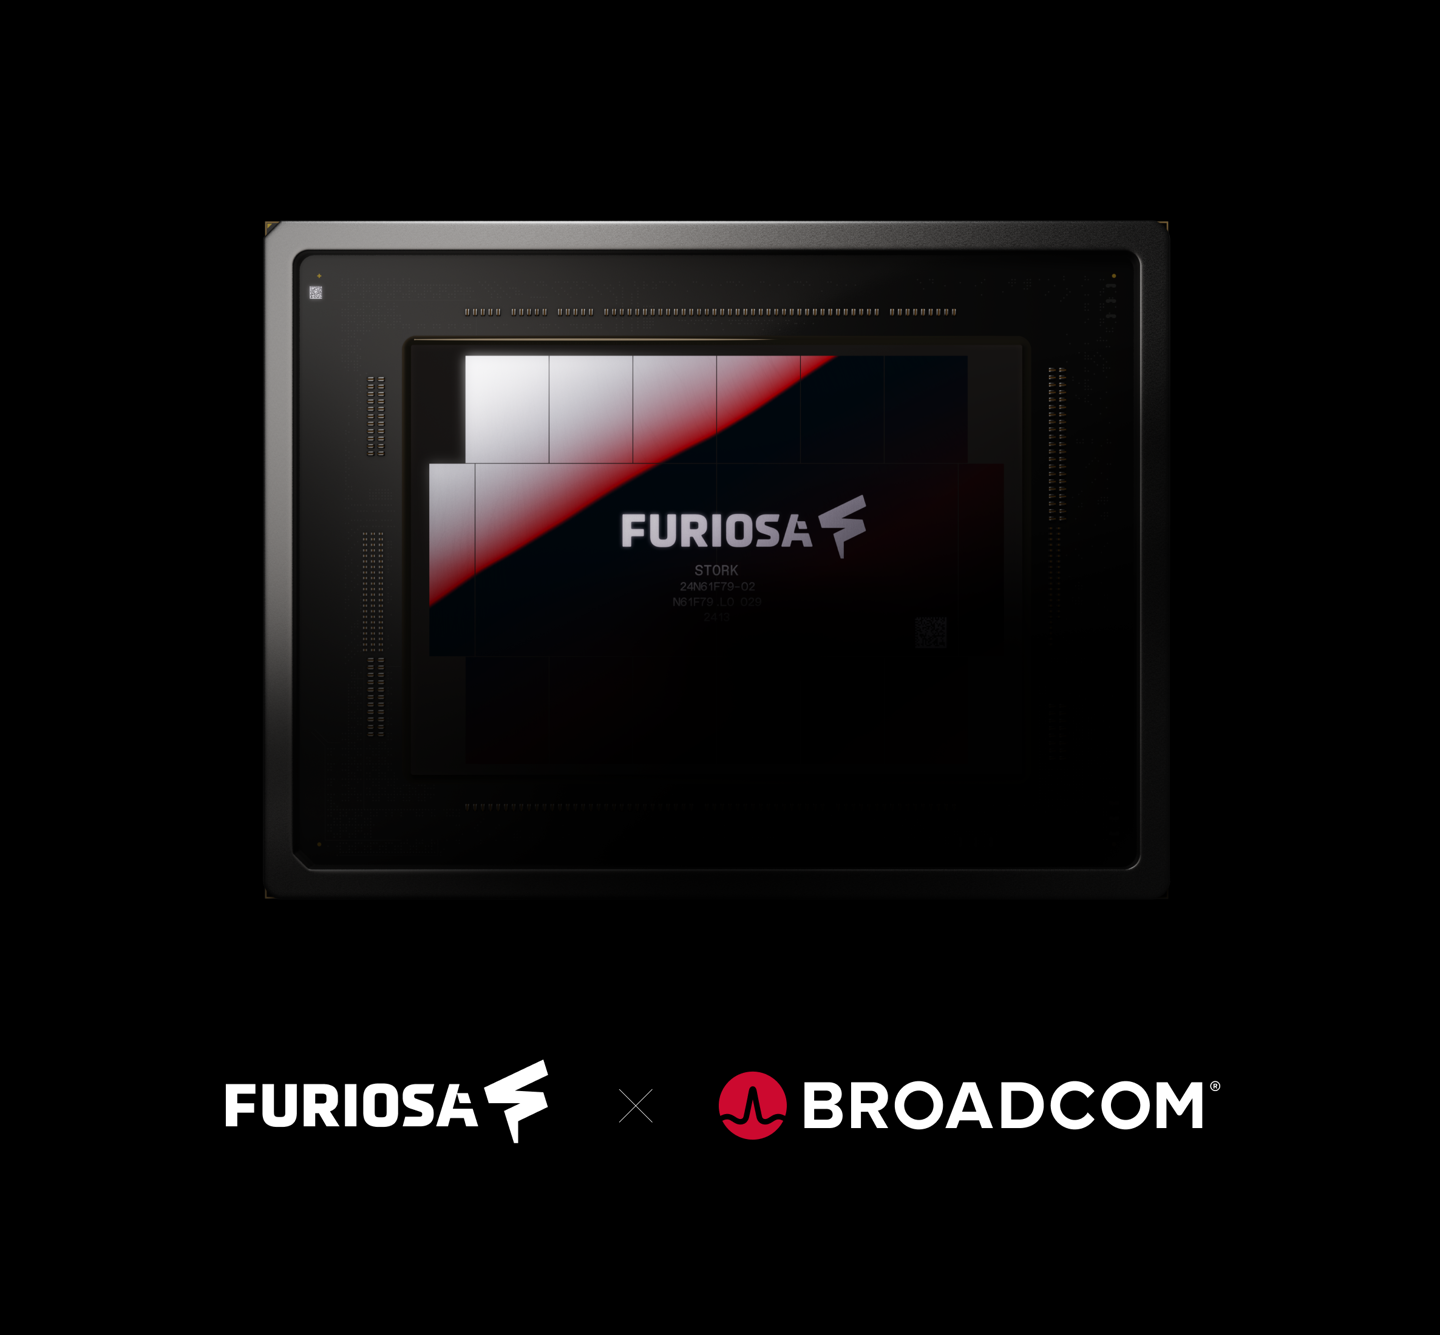
IT之家 9 月 22 日消息,据韩媒 ZDNET Korea 当地时间 21 日报道,韩媒 AI 半导体初创企业 FuriosaAI 昨日公布了其第三代 AI 推理加速器的技术细节。
该加速器由 FuriosaAI 与 Broadcom(博通)合作开发,拥有 2 颗“光罩极限级”2nm 计算裸晶、1 颗独立 I/O 裸晶、12 个 48GB HBM4 (E) 内存堆栈,机架内采用 SUE 全连接拓扑,还支持 PCIe Gen7。
FuriosaAI 表示,该芯片的物理尺寸大约是第二代芯片 (RGND) 的 8 倍;算力可达 32 PFLOPS,是 RGND 的 32 倍;HBM 内存容量达 576GB,是 RGND 的 12 倍;HBM 内存带宽达 48TB/s,是 RGND 的 32 倍。
功能建议、内容纠错或使用问题,请留下联系方式,我们会尽快处理。
品牌合作、商务对接、内容共建等,请留下联系方式,我们会尽快与您沟通。
欢迎投递行业稿件。请填写联系方式并上传 Word 文档(.doc / .docx),我们会尽快审阅回复。
仅支持 .doc / .docx,建议不超过 2MB(受服务器上传限制)
如果您希望与光互连开展更多商务合作,请发邮件至:
如果您对本网站有任何建议和反馈请联系
简体中文 English