在交互式视觉环境中,AI Agent 能否像人一样观察、推理和行动,并在陌生世界中从交互经验里持续学习?
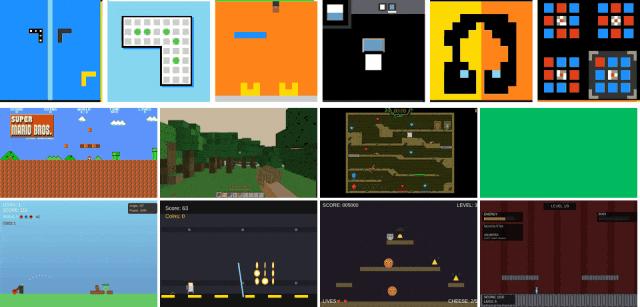
ARC-AGI-3 是检验这类能力的典型基准——在多项交互式视觉游戏中,Agent 需要在不清楚游戏规则和目标的前提下,通过与环境持续交互,自主探索并理解其中的规律。
目前的主流方法,是先将画面转换为文本或结构化网格,再交给大语言模型(LLM)进行推理,并结合程序合成构建可执行的世界模型。
直接使用视觉-语言模型(VLM)处理画面,则存在一些限制:图像通常会被编码成视觉表征,而原始视觉输入随后不再保留。这些经过压缩的视觉表征可能无法保留后续推理所需的细节。随着上下文接近容量上限,早期观察还可能被删除,或被替换成文字摘要。更关键的是,模型在最初观察画面时,并不知道未来的推理过程中究竟会需要哪些视觉信息。对于长程交互而言,这意味着 Agent 既可能“记不住”过去看到的内容,也可能无法重新获取当时的视觉细节,从而限制持续推理能力。
为此,深度残差网络(ResNets)之父、麻省理工学院(MIT)副教授何恺明团队提出了一个面向通用多模态模型的视觉 Harness——VISTA。
论文链接:https://arxiv.org/pdf/2610.02200
VISTA 的核心思路是:让模型直接观察渲染后的画面,并将环境返回的每一帧以原始形式无损保存,包括动作产生的中间动画帧。模型可以随时调取任意历史帧,也可以放大其中的任意区域,从而在长程交互过程中保留完整的视觉历史,并根据当前的推理需求重新检查视觉细节。
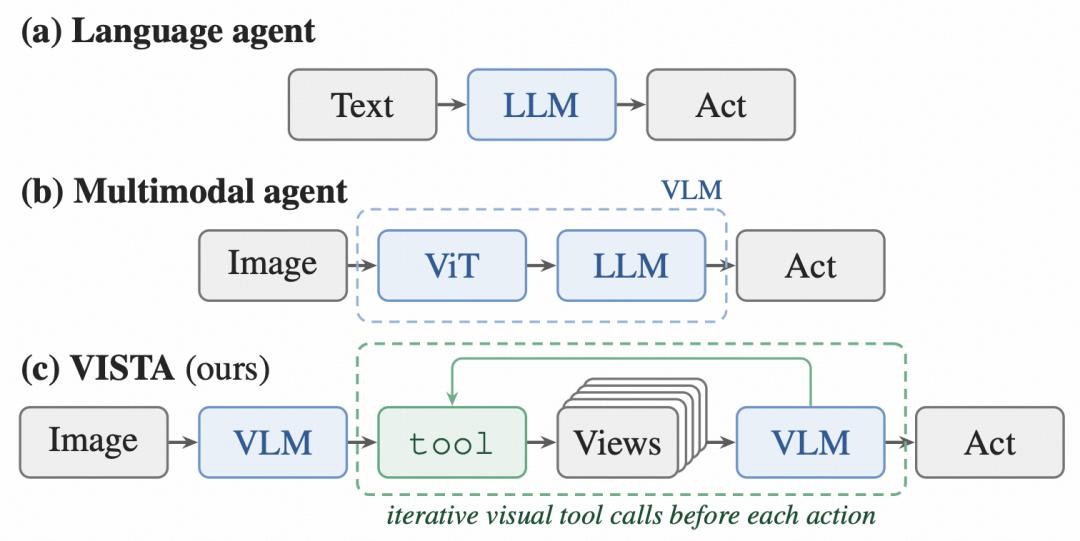
图|不同 Agent 设计的比较。
在 ARC-AGI-3 的 25 款公开游戏上,VISTA 将 Claude Opus 5.0 的相对人类行动效率(RHAE)得分从官方实现的 40.68 提升至 100.00,全部通关。整个过程中,Agent 共执行 7302 步,相比首次游玩的人类参照组的 17135 步减少了 57.4%。
据论文称,VISTA 是首个无需依赖程序合成、仅基于视觉输入即可达到满分表现的系统,有望作为一种通用视觉 Harness,进一步推动多模态 Agent 在复杂视觉环境中的发展。
一、研究方法
VISTA 的设计围绕一个核心判断展开:模型在编码画面的那一刻,并不知道哪些视觉信息会在后续推理中变得重要,任何一次性编码都可能丢掉后来才需要的信息。
因此,VISTA 不改动模型本身,而是围绕模型搭建了一套 Harness,给模型提供一种“对交互历史的显式注意力机制”。整个 Harness 包括以下三个核心组件:
视觉观察(Visual observation)。模型直接接收环境渲染后的图像,而非文本化网格。图像保留了物体的外观与空间关系,模型可以直接调用预训练中积累的视觉先验来理解环境。
默认情况下,VISTA 接收 512×512 的 PNG 图像,由官方 64×64 帧经过 8 倍最近邻上采样得到,每帧约消耗 308 个图像 Token。作为对比,同样的 64×64 文本网格约需要 4000 个 Token。
无损视觉记忆(Lossless visual memory)。环境返回的每一帧都会以其原始形式存储,包括动作触发的中间动画帧。每帧按“回合号 + 帧号”建立索引,如 t67 f0–f5),并在整个交互过程中保持可寻址。
这份记忆独立于模型的上下文存在,即使上下文中的历史信息经过压缩或被移除,完整的视觉记录仍然保留。
视觉检查(Visual inspection),这是 VISTA 的核心机制。模型可以在空间和时间两个维度上主动检查视觉记忆。在空间维度上,它可以选择任意帧中的任意矩形区域,请求放大后的视图,以全分辨率查看整幅图像中难以辨认的局部细节;在时间维度上,它可以一次性检索任意早先回合的多帧画面,比较不同状态,并通过中间动画帧回放动作产生的变化。
此外,模型还可以使用 read pixels 工具,读取选定区域内像素的精确 RGB 数值。
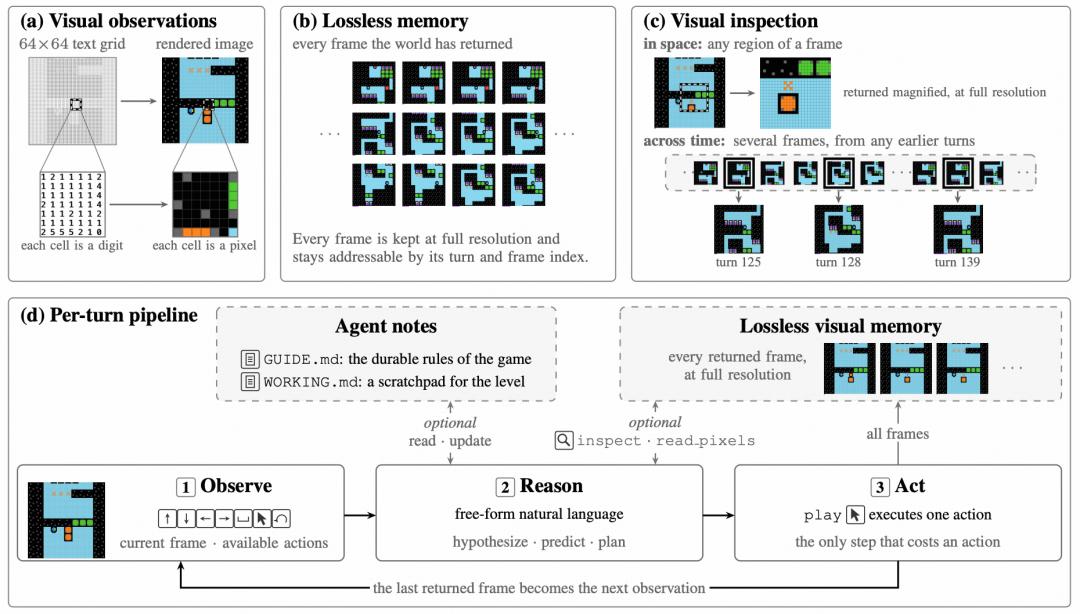
图|VISTA 的关键设计组分和每轮流程。
是否进行检查、检查哪些帧以及检查哪些区域,都由模型根据当前的推理需求自主决定。这样一来,模型获得了一种主动选择视觉证据的能力,可以在需要时重新查看过去的观察,也可以针对当前问题放大特定区域,而无需依赖最初一次视觉编码所保留下来的信息。
在具体流程上,模型与 Harness 通过多轮对话进行交互。Harness 本身不包含任何训练模型,只负责执行模型发出的工具调用、返回图像或像素值,并报告无效请求。每个游戏由同一个 Agent 贯穿完成;一个游戏回合内,Agent 可以与 Harness 进行多轮交互,随后调用 play 执行一个游戏动作。play 是唯一消耗游戏行动的步骤,inspect 和 read pixels 均不计入游戏行动。
与此同时,Agent 会维护两份笔记:GUIDE.md 用于记录对游戏机制的持久理解,并在不同关卡之间复用;WORKING.md 则作为当前状态下的临时工作区。模型采用自由格式的自然语言进行推理,提出假设、预测行动结果,并根据新的观察修订理解和后续计划。
当上下文接近容量上限时,Agent 会写下一份简短的交接摘要,在全新的上下文中继续运行。此时,GUIDE.md、WORKING.md、视觉记忆以及动作历史都会继续保留。所有游戏共用同一接口与同一段简短 Prompt,无需按游戏定制。
二、实验结果
研究团队在 ARC-AGI-3 的 25 个公开游戏上评估了 VISTA。评估指标 RHAE 对比了 Agent 与首次人类玩家的行动效率:完成关卡且行动数与人类基线持平得 100%,行动更少最高可得 115%,行动更多则拿部分分数,未完成的关卡计零分;越靠后的关卡权重越高。
结果显示,VISTA 配合 Claude Opus 5.0 取得 100.00 的满分 RHAE,配合 GPT-5.6 Sol 取得 99.00;同样的模型在官方实现下分别只有 40.68 和 13.33。使用 Claude Opus 5.0 的 VISTA 总共执行 7302 个行动,人类参考为 17135 个。
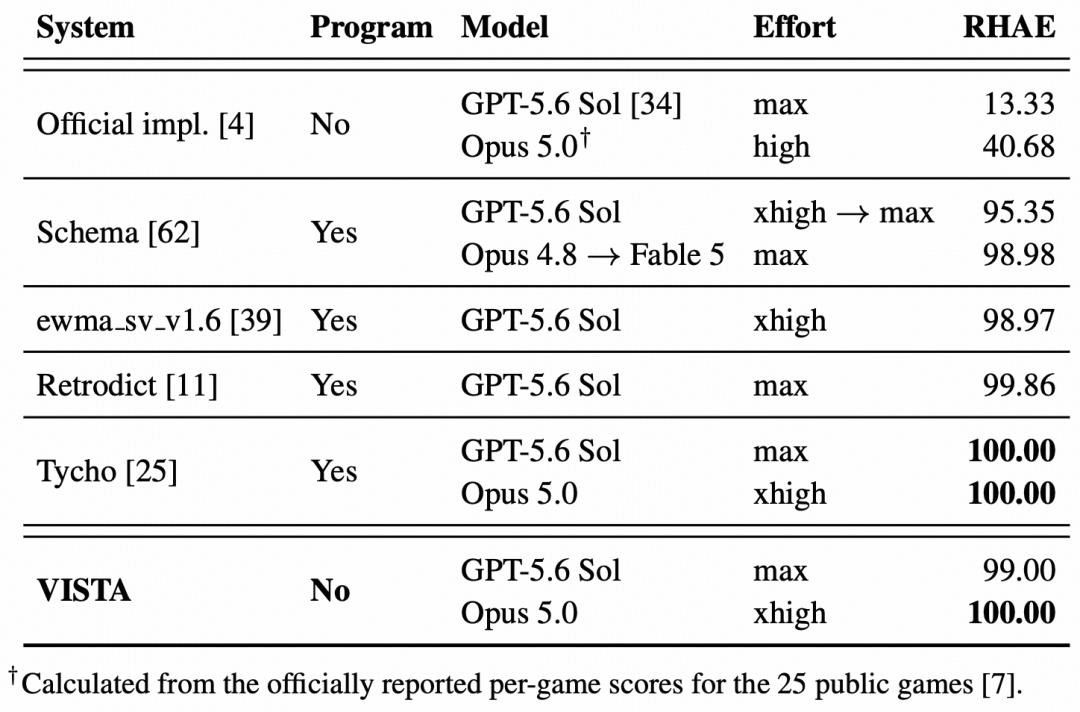
图|对 25 款公开游戏的系统级比较。
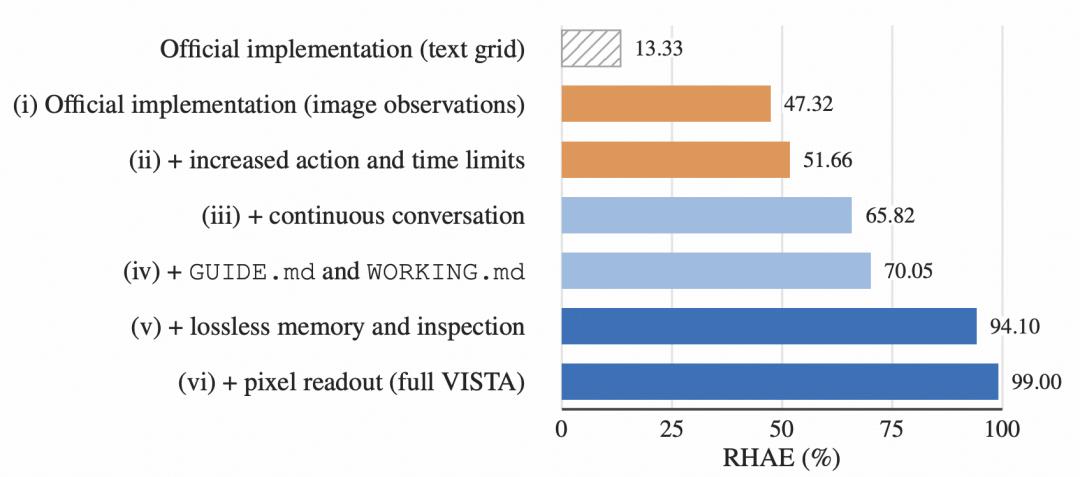
在消融实验中,他们逐项验证了各组件的贡献。如下图,官方文本网格实现得分为 13.33;将观察方式替换为图像后,得分升至 47.32;提高动作与时间限制后达到 51.66;加入持续对话与原生上下文压缩后升至 65.82;加入 GUIDE.md 与 WORKING.md 两份笔记后达到 70.05;引入无损视觉记忆与视觉检查后,得分大幅跃升至 94.10;进一步加入像素读取,完整 VISTA 达到 99.00。其中,无损视觉记忆与视觉检查带来的提升最大。
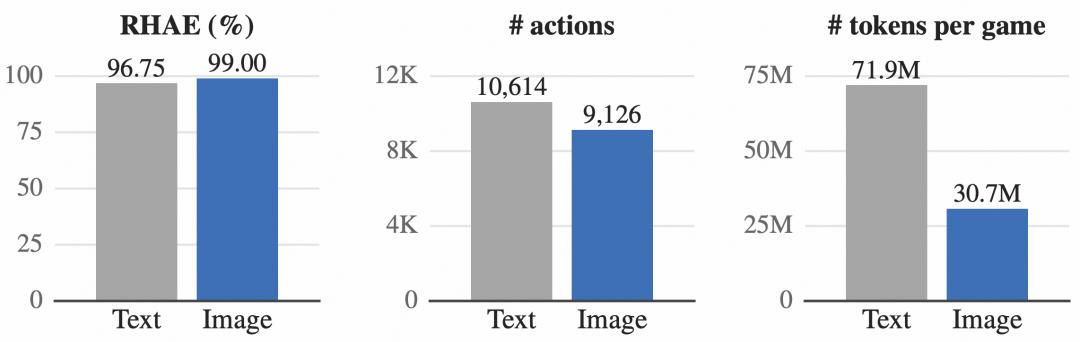
直接比较两种观察表示,也能体现视觉输入的优势。如下图,相比于文本网格,视觉输入在 RHAE 得分、总动作数、单个游戏的 token 消耗三个方面,均具有优势。
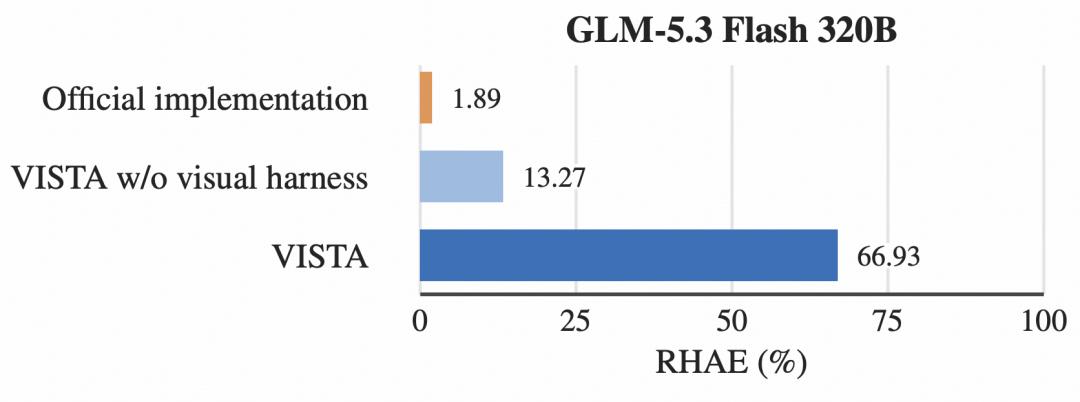
另外,VISTA 的效果也不局限于单一模型和单一渲染形式。使用开源模型 GLM-5.3 Flash 320B,VISTA 将得分从 1.89 提升到 66.93;去掉 inspect 与 read pixels 两个工具后,得分则降至 13.27。将同样的游戏渲染为 3D 画面后,VISTA 仍取得 84.12 的得分,尽管完成任务所需的动作数从 9126 增加至 20640。
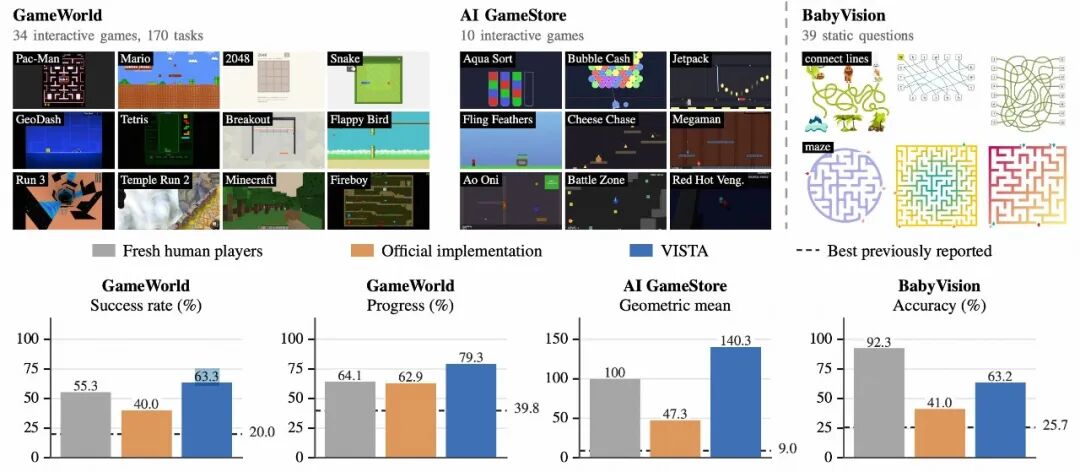
此外,他们还将同一套 Harness 以最小改动迁移到了 GameWorld、AI GameStore、BabyVision 三个新基准上。在 GameWorld 的 34 款浏览器游戏、170 个任务上,VISTA 的成功率达到 63.3%,任务进度达到 79.3%,均超过首次上手的人类玩家;在 AI GameStore 的 10 款游戏上,按人类中位数归一化后的得分几何平均值达到 140.3,高于人类基准的 100;在静态基准 BabyVision 的 39 道视觉追踪题目上,准确率也从官方实现的 41.0% 提升至 63.2%。
三、不足与未来工作
当然,这项研究依然存在一些局限性。
例如,模型自身的能力仍然是系统成功的关键。VISTA 只是提供了一种简单而有效的激发方式,其价值在于与模型能力的提升形成互补。
同时,他们所使用的模型发布时间晚于相关公开基准,因此无法排除这些游戏已经进入模型训练数据的可能性。未来如果能在 ARC-AGI-3 私有集等全新游戏上进行评估,将更有助于检验系统的泛化能力。
从更宏观的视角看,VISTA 的结果揭示了一个容易被忽视的变量:当多模态模型本身已经足够强时,如何组织观察与记忆,同样会影响 Agent 在长程任务中的表现。看什么、存什么,以及何时回看,都可能成为决定任务成败的重要因素。
他们认为,VISTA 的简单设计有潜力进一步拓展为游戏之外的通用视觉 harness。下一步,他们希望将其应用到更复杂、更真实的环境中,并在更接近物理世界的具身任务等场景中继续检验其有效性。
更多技术细节,详见原论文。
- 收藏